De Benchmark Answer Set Samenstellen
Een van de eerste dingen die we opzetten was een goede Benchmark Answer Set. We dachten aanvankelijk dat toegang tot een grote Q&A database deze taak zou vereenvoudigen. Al snel merkten we dat het kiezen van vragen die alle nuances afdekken lastig is. Ook het koppelen van de juiste bronnen bleek complex, vooral wanneer verschillende bronnen hetzelfde onderwerp behandelen. We kozen daarom voor een iteratieve aanpak, waarbij we de set stap voor stap verbeterden met feedback van domeinexperts. Zo hoefden we niet te wachten tot de Benchmark Answer Set klaar was en konden we de oplossing al optimaliseren met de beperkte content die we hadden.
Het Evaluatieframework Bouwen
Het opzetten van een evaluatieframework zelf is relatief eenvoudig. Toch vergde het fine-tunen van de metrics om ervoor te zorgen dat ze onze doelen nauwkeurig weerspiegelden behoorlijk wat inspanning en aandacht. Metrics zoals recall lijken op het eerste gezicht simpel, maar in de details gaat het makkelijk mis. We moesten onze methoden voortdurend opnieuw beoordelen om ervoor te zorgen dat ze afgestemd bleven. Hoewel onze focus meer lag op trends in een bepaalde richting dan op absolute cijfers, maakten nauwkeurige metingen de inzichten wel een stuk bruikbaarder. De belangrijkste metrics die we gebruikten om de prestaties te meten waren Recall, Precision/Mean Reciprocal Rank (MRR) en een LLM-gebaseerde correctheidsmetric. Samen gaven die een goed beeld van hoe het systeem presteerde.
Systeemcomponenten: Van Prototype naar Bèta
De overgang van een prototype naar een bètaversie omvat de integratie en verfijning van meerdere systeemcomponenten. Als je een prototype hebt, heb je waarschijnlijk de volgende componenten al opgezet:
- Een basis pipeline voor het cleanen, chunken en embedden
- Een retrieval systeem dat gebruikmaakt van similarity searches
- Een mechanisme voor het genereren van antwoorden
Naarmate we vorderden naar de bètafase, kwamen daar meer lagen bij:
- Een uitgebreidere pipeline met betere technieken voor dataverwerking
- Een classificatielaag voor slimmere routing van queries
- Een query expansion laag om vragen te ontleden en de scope te verbreden
- Een reranker om resultaten samen te brengen en te prioriteren
- Een guardrails laag om antwoorden en bronnen te valideren
Projecthouding: Detailgericht en Hands-On
Gedurende het project hing ons succes minder af van de metrics zelf en meer van ons vermogen om elk aspect van de pipeline te onderzoeken. Dat betekende in de details duiken: onbeantwoorde vragen onderzoeken, gemiste bronnen opsporen en kleine onderdelen van de oplossing steeds opnieuw testen en bijschaven. Domeinexpertise alleen is daarvoor niet genoeg. Je moet met de data bezig zijn, patronen herkennen en onderbouwde aanpassingen doen aan de vele componenten die je kunt optimaliseren.
De Semantic Match Verbeteren
De belangrijkste taak is het verbeteren van de semantic match tussen een vraag en de bijbehorende content waaruit het antwoord kan worden gehaald. In ons project plotten we de embeddings in 2D en konden we duidelijk het verschil onderscheiden tussen de belangrijkste content (blauw) en vragen (rood). Gelukkig voor ons was er al content aanwezig die fungeerde als brug tussen de vragen en de hoofdcontent. Maar als je niet zo gelukkig bent en die brug niet hebt, kun je strategieën overwegen zoals HyDE of het genereren van synthetische content om de kloof te overbruggen.
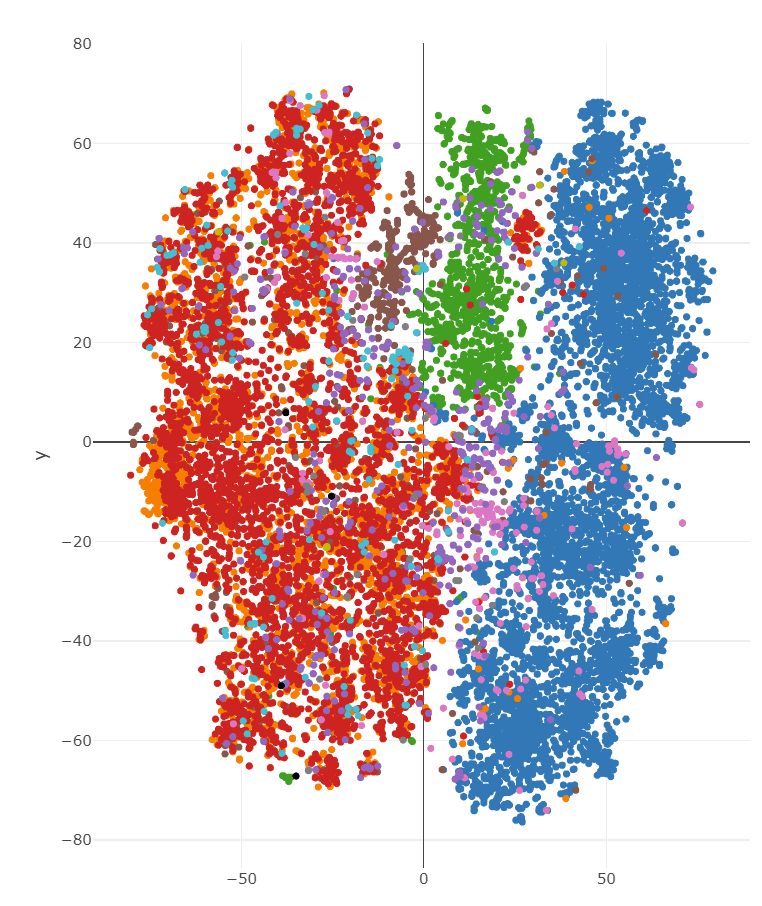
De 2D-projectie van onze content (blauw) en query (rood) embeddings.
Met query expansion kun je je richten op verschillende elementen van de vraag (bijvoorbeeld een specifiek element van je bedrijf) om meerdere soorten content in je database aan te raken. Het probleem met deze aanpak is dat je de resultaten van verschillende queries moet samenbrengen, samenvoegen en ontdubbelen. Aangezien je nu waarschijnlijk veel meer resultaten krijgt, wordt een reranker laag belangrijk.
Een reranker is een langzamer maar preciezer model (vergeleken met een embedding model) dat de gelijkenis tussen de vraag en de content meet. In ons geval bleek reranking erg lastig te zijn, omdat commerciële aanbiedingen zoals Cohere en Jina niet voor ons werkten, waardoor we waren aangewezen op grotere en langzamere modellen. De reden hiervoor was het zeer specifieke domein waarin we opereerden en Nederlands als de belangrijkste taal. Voor meer algemene toepassingen zouden rerankers waarschijnlijk heel goed hebben gewerkt.
Dit deel van het project laat zien dat je niet zomaar een best practice kunt toepassen en goede resultaten kunt verwachten. Je moet testen wat werkt voor jouw specifieke geval. We verwachtten bijvoorbeeld dat het implementeren van reranking relatief triviaal zou zijn en uiteindelijk ging de meeste ontwikkeltijd in deze laag zitten, zonder een perfect resultaat.
En soms heb je wat geluk nodig
We kregen een flinke duw in de rug door de release van OpenAI's nieuwe embedding modellen, die de similarity matching verbeterden. Onze recall ging met 10%-15% omhoog, alleen al door over te stappen van text-embedding-ada-002 naar text-embedding-3-large. We hebben ook een embeddings model fine-tuned dat specifiek was voor ons domein, maar helaas waren de resultaten verre van perfect, waarschijnlijk vanwege de taal.
Houd de volgende post in de gaten waarin ik dieper inga op het tweede deel van dit project van 2 maanden, het opzetten van guardrails, het fine-tunen van prompts en de voorbereiding op een succesvolle bètalancering.