Omdat dit zo'n basisonderdeel van AI is, vinden we dat je het moet begrijpen als jij en je bedrijf serieus zijn over data, ook als je er niet direct mee werkt. Hieronder leggen we uit wat vector embeddings zijn, zonder al te diep in de techniek te gaan.
Wat zijn vector embeddings?
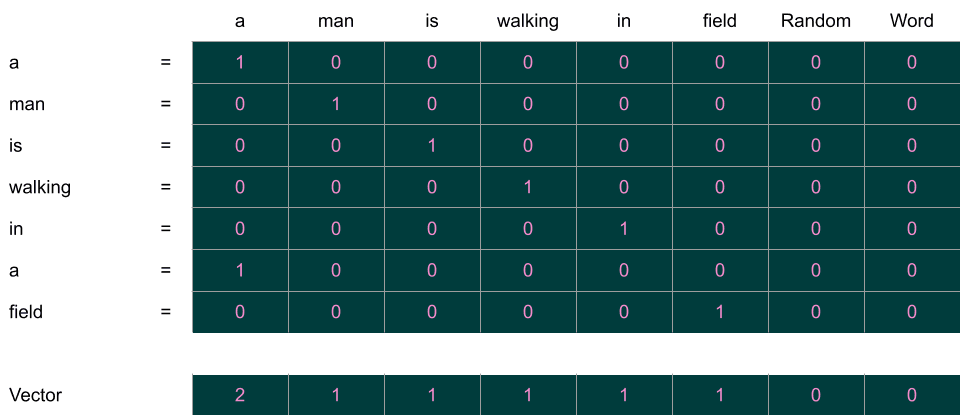
Kort gezegd is een vector embedding een numerieke representatie van tekst, beelden, geluiden, enzovoort. Je kunt bijvoorbeeld elk woord van een zin nemen en er een getal aan toekennen, wat een elementaire vector embedding is. We kunnen bijvoorbeeld de zin 'Een man loopt in een veld' vertalen naar een vector van getallen.
De vector embeddings in moderne AI-applicaties zijn complexer. Als we bij tekst blijven, zal het proberen de essentie van een zin op een vector te mappen. Zo kun je in een voorbeeld dat door Word2Vec is gedeeld (een vroege implementatie uitgevonden door Google) verschillende dieren gemapt vinden op een set concepten.
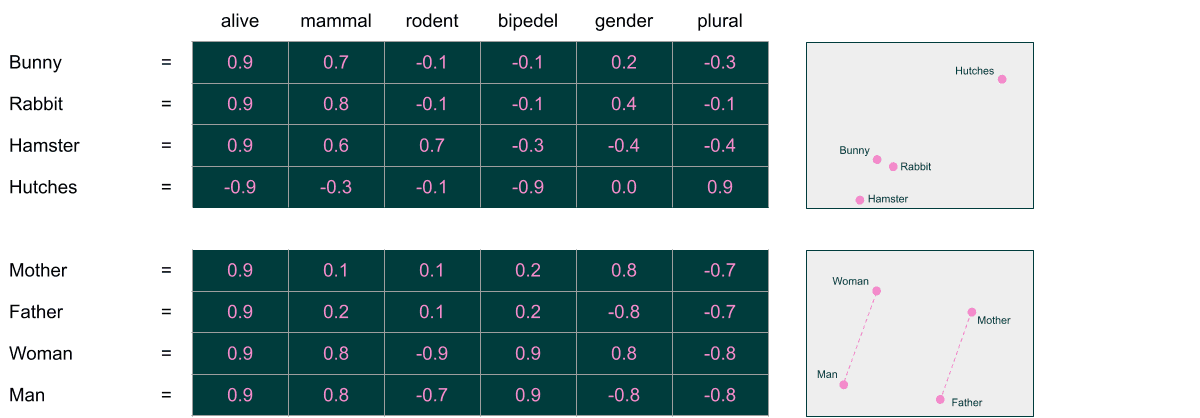
Dit voorbeeld mapt naar 6 verschillende dimensies, maar echte vector-mapping kan honderden of duizenden dimensies hebben. Dat kunnen we ons niet voorstellen, maar het is hetzelfde als gaan van 2-dimensionale ruimte naar 3 dimensies, je voegt meer mogelijkheden toe. Stel dat je alleen de optie van gehele getallen hebt op een schaal van 1-100. 1 dimensie zou je 100 posities geven, de tweede dimensie zou 100x100 = 10000 posities geven en de derde dimensie zou je al 1 miljoen posities geven (100x100x100).
Wat kun je met die vector embeddings doen?
Nadat de vector embedding is gemaakt, hebben we dus een numerieke representatie van de tekst. Omdat het getallen zijn kunnen we ermee rekenen. Dat opent veel mogelijkheden, die allemaal neerkomen op hetzelfde idee, namelijk dingen vinden die dicht bij elkaar liggen. Of het nu gaat om het maken van clusters, het vinden van het beste alternatief of het identificeren van afwijkingen, het komt allemaal neer op hoe dicht verschillende vectoren bij elkaar liggen.
De grafieken aan de rechterkant tonen een 2D-visualisatie (dimensiereductie) van het Word2Vec-voorbeeld. Daar liggen het konijntje en het konijn heel dicht bij elkaar omdat ze het concept van zoogdier en niet-knaagdier delen. In sommige gevallen wordt de hamster ook als dichtbij beschouwd, terwijl die in andere gevallen als onderdeel van een ander cluster wordt gezien.
Terug naar het eerdere voorbeeld van "Een man loopt in een veld", dit ligt nu dichter bij de tekst "een kleine jongen loopt" dan bij "een hond loopt langs een veld". Hoewel de zinnen "Een man loopt in een veld" en "een hond loopt langs een veld" meer op elkaar lijken, is de connectie tussen een man en een kleine jongen sterker. Dus de similarity score van die twee zinnen is hoger.
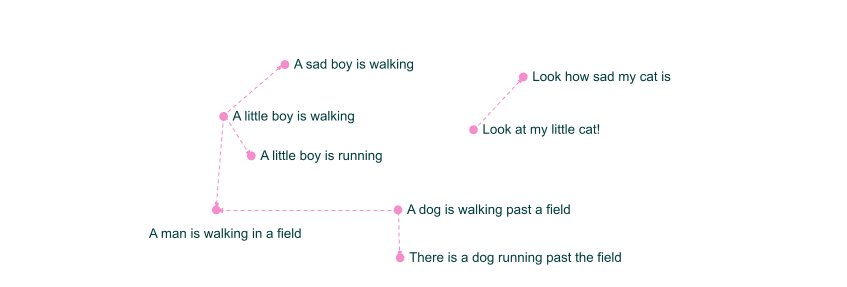
Als we al deze teksten in een database hebben, kunnen we de nabijheid berekenen ten opzichte van de string die we zoeken. Dit is wat we een similarity search noemen.
Wat zijn de toepassingen voor vector embeddings?
Hoewel veel mensen nu opeens bekend zijn met vector embeddings, wordt het concept al jaren toegepast. Een Google image search of een aanbeveling nadat je een serie op Netflix hebt afgekeken, het is allemaal gebaseerd op dit concept.
Een paar voorbeelden van wat je met vector embeddings kunt doen:
- Magische foto-editors, bijvoorbeeld mensen uit de achtergrond verwijderen
- Productaanbevelingen
- Chatbots die vragen beantwoorden op basis van jouw data
- Klanten identificeren die dreigen weg te lopen
- De-duplicatie van data
- Anomaliedetectie
Een voorbeeld, van een use-case van vector embeddings?
Onlangs deden we een project waarbij we een chatbot ontwikkelden om vragen te beantwoorden over een dataset van miljoenen artikelen. We gebruikten een systeem om alleen de relevante artikelen op te halen, met de ideeën die in deze post worden besproken. We vectoriseerden de vraag en vergeleken die vector met de vectoren in de database (similarity search), wat leidde tot 10 artikelen die werden gebruikt om de vraag te beantwoorden.
We bespreken dat project in een vervolgpost, maar je kunt nu al meer informatie over dat project vinden in de use-cases.