In 2012 versloeg het inmiddels beroemde AlexNet de andere modellen overtuigend in de ImageNet-competitie en dat luidde de brede adoptie van Convolutional Neural Networks (CNN's) in. Vrijwel van de ene op de andere dag halveerde deze variant van deep learning het foutpercentage ten opzichte van de beste andere computer vision-technieken van dat moment. Het was het begin van een snelle verbetering van computer vision-modellen, die al gauw de nauwkeurigheid van mensen benaderden.
Nu, in 2024, zitten we midden in een nieuwe verschuiving. Waar 2012 een sprong in prestaties bracht, gaat het nu om een sprong in toegankelijkheid, met generalistische computer vision-modellen die een breed scala aan taken kunnen oplossen. Net als in natural language processing wordt dit gedreven door de Transformer-architectuur, dezelfde die ten grondslag ligt aan Large Language Models en ChatGPT.
De manier waarop we computers laten zien gaat veranderen
Het huidige paradigma van computer vision draait om enorme hoeveelheden beelden verzamelen, uitgebreid labelen en voor elke taak een gespecialiseerd model trainen. Daarna valideer je het model op data en hoop je dat het de echte wereld aankan, die vol edge cases zit. Dat is omslachtig en het is dan ook geen verrassing dat er veel gespecialiseerde computer vision-bedrijven zijn ontstaan die computers helpen taken op te lossen die voor mensen soms heel alledaags zijn.
Met de komst van Multimodale LLM's gaat dit veranderen en die verschuiving gaat nog vrij onopgemerkt voorbij, zoals Ethan Mollick in deze recente tweet opmerkt:
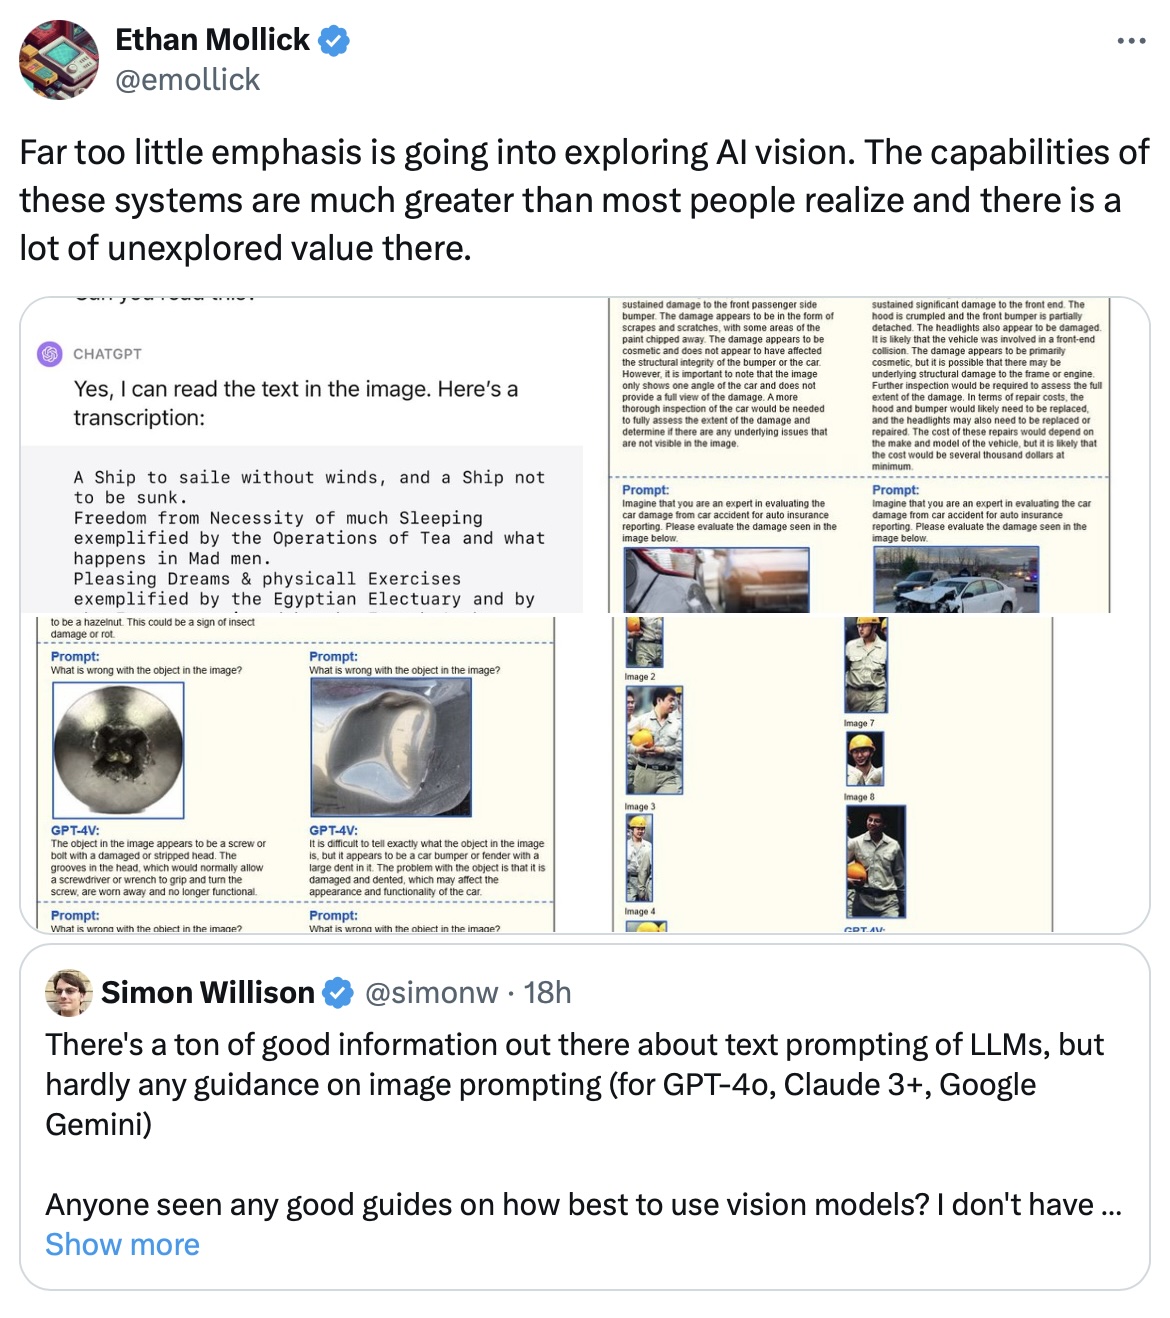
Ethan Mollick merkt op hoe weinig aandacht er is voor wat AI-vision nu al kan.
Wie experimenteert met multimodale modellen zoals OpenAI's GPT-4o, Anthropic's Claude Sonnet 3.5, Google's PaliGemma of Tencent's YoloWorld, merkt al snel dat er iets aan het veranderen is. Modellen waren alleen toegankelijk voor experts. Nu vertel je een generalistisch model (in een prompt) welke vision-taak het moet oplossen en het doet het.
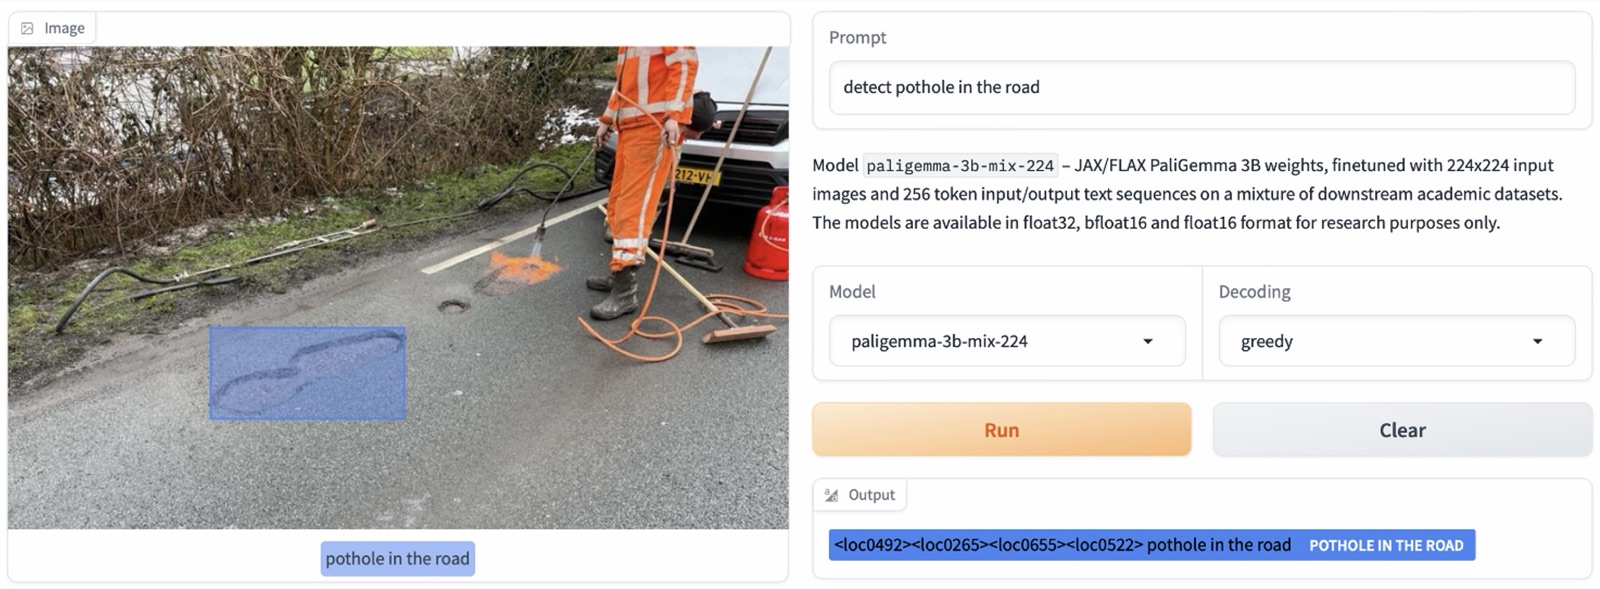
Kijk, ik heb een gat-detector getraind, uhh, geprompt
Het is nog vroeg dag, dus verwacht geen perfectie
Multimodale LLM's lossen vandaag al uiteenlopende computer vision-taken op, maar ze hebben nog hun problemen. Of je ze moet toevoegen aan je computer vision-oplossing hangt, zoals met alles in het leven, ervan af.
Los je complexe vision-taken op waar ook mensen moeite mee hebben en waar nauwkeurigheid zwaar weegt, dan is een LLM in je stack misschien (nog) niet het beste idee. Werk je aan eenvoudigere vision-taken waarbij een incidentele fout acceptabel is, dan is experimenteren met Multimodale LLM's het overwegen waard, vooral tijdens prototyping of opschaling.
Blijkt je oplossing nuttig, dan kun je altijd nog je eigen computer vision-modellen trainen, wat goedkoper en sneller kan zijn. Een alternatief is de kennis van deze grote modellen distilleren naar kleinere modellen die bijvoorbeeld op edge devices draaien, zoals in deze blogpost: LLM Knowledge Distillation: GPT-4o.
Evaluatie blijft een cruciale factor voor succes
Met deze LLM-systemen hoef je zelf geen modellen meer te trainen, dat hebben bedrijven als OpenAI al gedaan. Data verzamelen en goed evalueren blijft wel nodig.
In het huidige paradigma verzamel je veel beelden om je model te trainen en gebruik je een deel daarvan voor evaluatie. In het nieuwe paradigma train je geen model, maar je moet nog steeds je prompts optimaliseren en de prestaties van je systeem valideren. Daar heb je data voor nodig, gelukkig veel minder dan voor het trainen van een model vanaf nul.
De huidige generatie LLM's heeft nog steeds vervelende failure modes en dat is niets nieuws. Of je LLM's nu gebruikt voor Retrieval-Augmented Generation (RAG), tekstgeneratie of, zoals hier, computer vision-taken, zonder goede evaluaties kom je er niet. Zie bijvoorbeeld onze eerdere blogpost over Pushing a RAG Prototype to Production.
Onderschat het potentiële voordeel van een eerste succes niet
Lukt het om je computer vision-probleem goed genoeg op te lossen met een multimodale LLM, dan zit je in een gunstige positie. Je lift dan mee op de richting waarin de LLM-markt snel beweegt, met betere modellen tegen lagere prijzen (zie ook onze vorige blog hierover: The Era of Choice in AI).
Met weinig inspanning wordt je oplossing beter en goedkoper om te draaien. Je hoeft alleen je evaluaties in de gaten te houden en je prompts af te stemmen op nieuwere modellen.
De komende jaren in computer vision gaan wat mij betreft minder over nog betere prestaties en meer over het eenvoudiger en toegankelijker maken van de techniek voor iedereen.